

英文论文在线PDF翻译:解决排版前后格式错乱,从“翻完能读”到“翻完能用”的关键一步
英文论文在线PDF翻译是科研用户问得最多、也最容易踩坑的一件事。很多人以为把文献传上去、点一下翻译,拿到中文就算完事。但真正折磨人的从来不是“有没有译文”,而是译文回来之后,公式断了、图表飞了、双栏错成单栏,原本十分钟能读完的段落,花了半小时在拼版上。
这个困境的根源,在于通用翻译引擎和学术PDF之间天然的不兼容。Google翻译、DeepL在纯文本上表现不俗,但一旦面对学术论文中密集的数学公式、跨栏段落和结构化表格,解析层就率先失守。一篇讨论Transformer注意力机制的论文,公式里的下标被当成正文翻掉,符号体系瞬间崩塌。开源社区之所以反复推出PDFMathTranslate一类工具,恰恰说明“保留公式与排版的论文翻译”是一个被长期忽视、却绕不开的刚需。
翻译狗处理英文论文在线PDF翻译的思路,不是在翻译环节“事后补救”,而是在解析环节“前置解决”。其文档翻译服务依托神经网络智能场景翻译系统NISTS和全景内容识别技术PCR,在翻译之前先完整理解PDF的版式结构:双栏自动识别,公式和参考文献格式原样保留,图片、表格、公式不乱码,翻译结果实现1:1无损还原原文排版。这意味着你拿到的不是一份“需要再排一次版”的译文,而是一份可以直接进入精读状态的文档。对于需要批量整理文献的科研场景来说,减少的二次排版工作量,远比“多翻对几个词”更有实际价值。
术语的准确,比句子的通顺更关乎论文翻译的成败。学术阅读中真正致命的不是一句话读起来别扭,而是一个核心概念被译成了“看起来差不多、实际上不是一回事”的中文。ACL 2026发布的一项跨语言科学论文翻译研究显示,基于大语言模型的学术翻译在关键科学细节上的传达准确率可以达到95.9%,但仍有约三分之一的作者反馈部分技术术语存在“过度翻译”,更希望保留英文原词以维持学术共同体的认知习惯。翻译狗在术语层面的应对方式是“可控”而非“放任”:内置医学、法律、工程、科研等垂直领域术语库,支持用户导入自建术语库,在文档翻译过程中自动匹配、全文统一译法。翻译狗英文论文在线PDF翻译的价值不在于替用户做术语决定,而在于把术语一致性的控制权交还给最懂那篇论文的人。
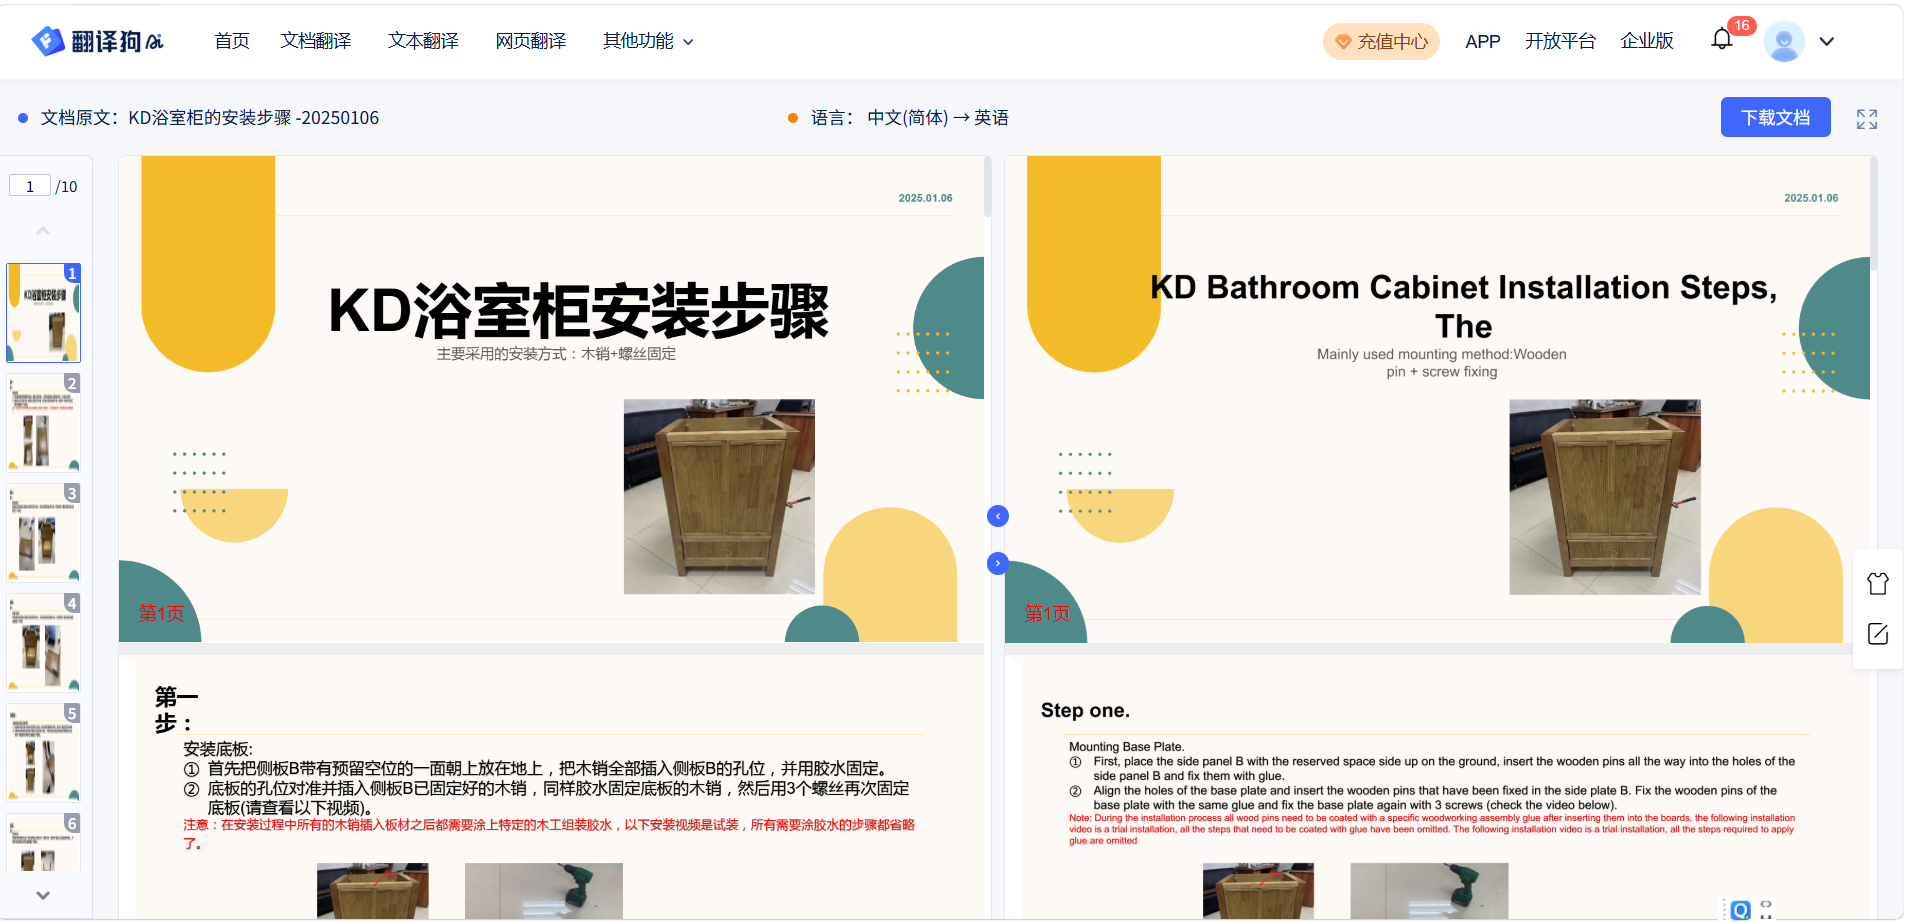
隐私边界,是在线翻译不能被跳过的一问。在线PDF翻译的便利,默认前提是“文件离开本机”。整份上传、片段上传、完全本地运行,三种模式的风险等级截然不同。翻译狗提供网页端、App和开放平台API/SDK等多种接入方式,企业场景下还支持私有化部署和自定义水印,本质上是在“在线翻译的效率”和“科研数据的可控性”之间给出分层选项。对于尚未发表的课题数据或涉密项目材料,选择匹配自身安全边界的接入方式,比单纯比较翻译速度更有意义。
回到最初的问题:英文论文在线PDF翻译到底应该怎么选?判断标准其实可以归结为一句话——译文能不能让你“接着往下做”,而不是“从头再弄”。排版前后格式错乱不出现,格式不塌,公式不丢,术语可控,隐私有边界,这四条守住,在线翻译才算真正进入了“可用”的区间。翻译狗官网咨询中反复被验证的经验也正在于此:科研阅读的时间应该花在理解内容上,而不是花在修复工具留下的残局上。